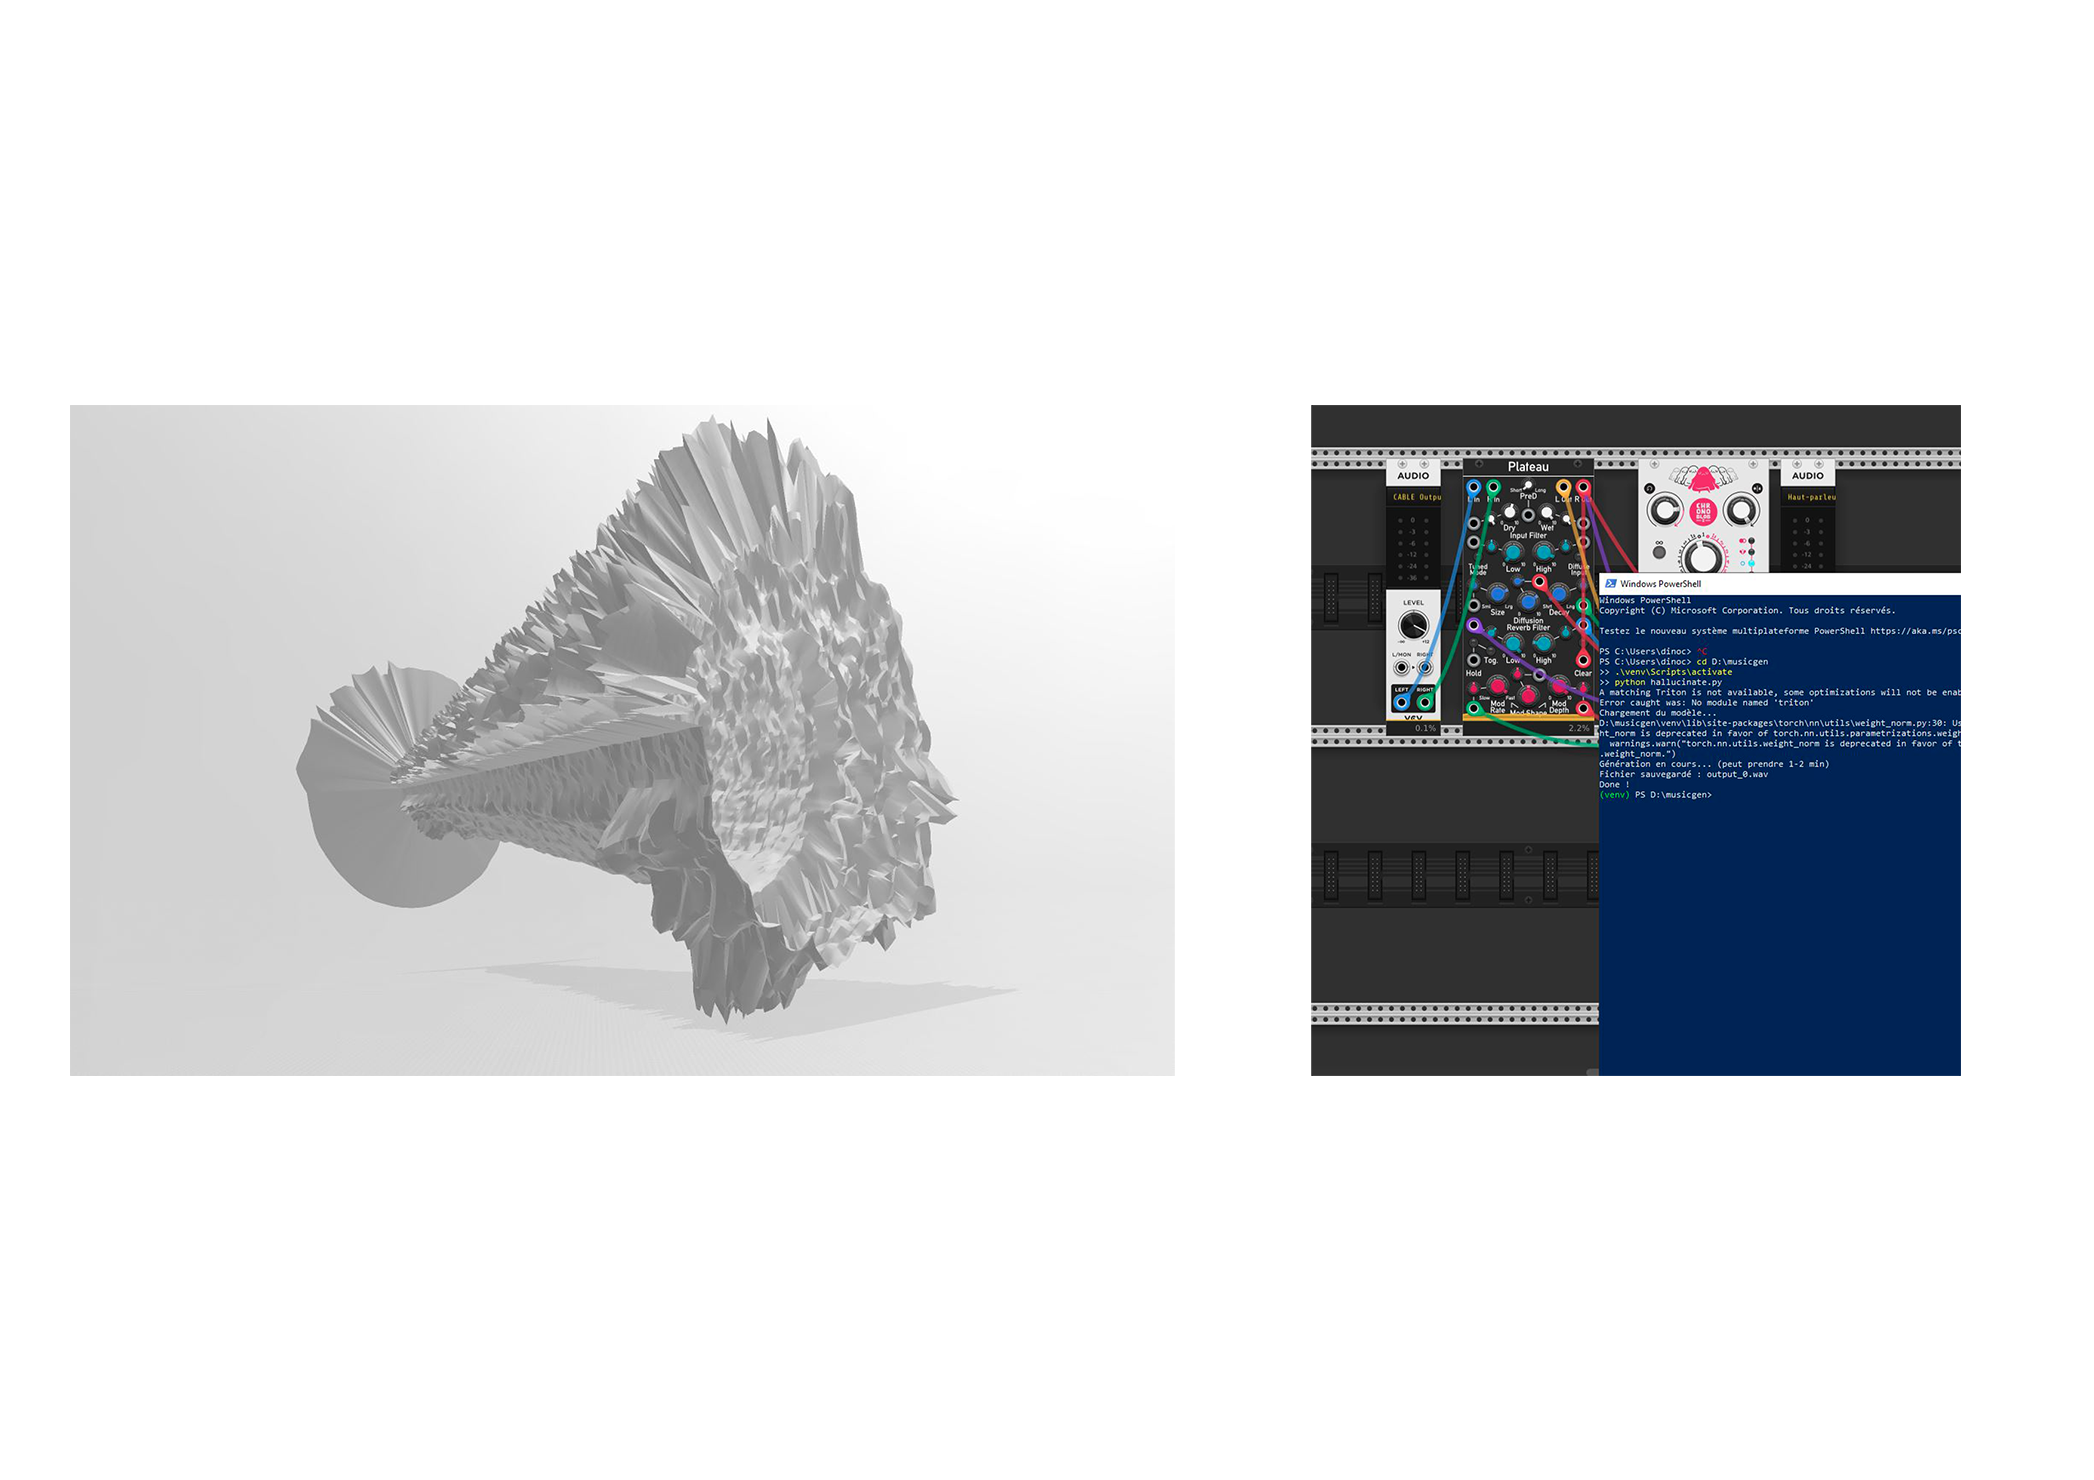
SculptSound est un programme simple : un fichier audio brut (.raw) est chargé, ses octets sont inversés par blocs, puis réinterprétés comme des triplets d’entiers 16 bits, c’est-à-dire comme des coordonnées $xyz$. Le résultat est un mesh 3D exporté au format GLB, consultable directement dans un navigateur. Aucun modèle, aucun apprentissage : il s'agit d'une traduction forcée. Les mêmes données, lues dans un autre cadre sémantique, produisent un autre monde. Ce geste s’inscrit dans la continuation directe du databending pratiqué au sein de Bâtiments (2024), mais selon une trajectoire inverse : là où le databending corrompt un fichier image en l’ouvrant comme donnée brute, SculptSound extrait des données sonores pour les soumettre à un contexte de lecture géométrique. La donnée n’est pas interprétée, elle est redirigée. Ce qui était une onde devient un relief ; ce projet matérialise ainsi l'intégration progressive du son au cœur de ma pratique artistique.L’autre axe de ce territoire explore une forme performative en développement : MusicGen, le modèle de synthèse musicale de Meta, s'exécute en local pour générer des blocs (chunks) audio à la demande depuis un terminal. Ces flux sont ensuite routés vers le logiciel open source VCV Rack via un câble audio virtuel (VB-Cable) pour être modulés, filtrés et traités en temps réel. L’intention n’est pas encore celle d’un concert public, mais le dispositif se précise : une scène épurée, un appareillage visible et un son complexe, exigeant, interrogeant la possibilité d'un panpsychisme synthétisé par le son. — · —
Ici, le machine learning se mêle à une pratique sonore et à la manipulation de ses flux, donnant corps à une collection d’apparitions sonores issues du code. Ainsi, le dernier travail présenté dans ce document prend la forme d'un dossier incrémentiel de scripts Python visant à éprouver les possibilités de l’IA locale appliquée au son et à la musique. Lorsque l'on convoque l'histoire de la scène noise japonaise — à l'instar de figures comme Merzbow, Hanatarash, ou des labels Less Than Zero et Alchemy —, on observe une esthétique radicale, développée dès les années 1980, où l’hostilité sonore s’impose comme une véritable stratégie d’attention. Le son n’est pas conçu pour être aimé, ni même pour faire l'objet d'une écoute passive ; il est déployé pour contraindre le spectateur à se confronter au dispositif, au message et au geste. L’inconfort neutralise la distraction esthétique. C’est précisément dans cette tradition que s’inscrit l’ambition performative de mon travail : exposer le calcul en train de se faire, rendre visibles la latence de génération et la fenêtre du terminal. Il s'agit, métaphoriquement, de montrer le câble apparent plutôt que de le dissimuler derrière un résultat poli, afin de désacraliser la distance habituellement imposée par nos interfaces informatiques. MusicGen n’est pas un instrument. C’est un modèle de langage appliqué à l’audio, une distribution de probabilités sur l’espace des sons, entraîné sur un corpus de musique humaine. Lorsqu’il génère un fragment sonore à partir d’un prompt textuel, il ne compose pas : il prédit. Ce son n’a jamais existé avant l’exécution du script, et pourtant il résonne comme un écho familier. Il est l’apparence d’un son, la phénoménalité sonore d’un entraînement archivé. Il y a dans ce signal un corpus absent, une mémoire collective que je cherche à mettre en tension dans mon travail. La question que soulève ce script est symétrique : si un modèle produit l’apparence d’un son à partir de statistiques, que produit-on lorsqu’on force un son à apparaître sous la forme d’un volume géométrique ? La réponse est identique dans les deux cas : une ontophanie construite, un monde fabriqué par le choix du contexte de lecture. C’est peut-être là la thèse centrale de l’ensemble de ma pratique : toute représentation est une traduction, et toute traduction est un acte de pouvoir.